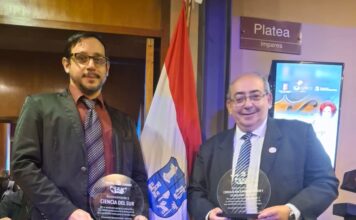

Un equipo de investigadores paraguayos y coreanos obtuvo el Best Paper Award en la 12.ª Conferencia Internacional sobre Tecnología de Plataformas y Servicios (PlatCon-26), realizada en Corea del Sur, por una investigación que utiliza inteligencia artificial para mejorar la clasificación automática de elementos figurativos en marcas. El trabajo aborda las categorías que cuentan con pocos o ningún ejemplo disponible para entrenar sistemas de IA, uno de los principales desafíos de la Clasificación de Viena.
The 2026 International Conference on Platform Technology and Service, coorganizado por el ICRP (Institution of Creative Research Professionals) y el National Center of Excellence in Software de la Shinhan University, se realizó del 24 al 26 de agosto en Jeju.
El artículo premiado se titula “Language-Aligned Fine-Tuning for Long-Tail Vienna Classification in an AI-Assisted Trademark Examination Platform” y presenta un método de inteligencia artificial destinado a mejorar la clasificación automática de los elementos figurativos presentes en las marcas comerciales.
La investigación forma parte de un proyecto más amplio orientado al desarrollo de un “Sistema Informático para la Búsqueda de Elementos Figurativos con herramienta de Inteligencia Artificial” para la Dirección Nacional de Propiedad Intelectual (DINAPI). Es financiado por la Agencia de Cooperación Internacional de Corea (KOICA) y gestionado por el Centro de Innovación TIC (CIT) de la Facultad Politécnica de la Universidad Nacional de Asunción (FP-UNA).
En el equipo participan Eduardo Cappiello Candia, Mirtha Balbuena, Diego Delpino, José Luis Vázquez Noguera, Luz Melinna Vázquez Benítez, Yandry Fernández Font, José Evaristo Ramírez Delvalle, Helena Gómez-Adorno, Suhan Park, Yaesop Lee, Eun-Seong Kim y Nam-Young Kim.
La investigación se concentra en un problema conocido en aprendizaje automático como long-tail, que aparece cuando algunas categorías cuentan con muchísimos ejemplos para entrenar un modelo, mientras otras tienen muy pocos o directamente ninguno.
La Clasificación de Viena, administrada por la Organización Mundial de la Propiedad Intelectual (OMPI), organiza los elementos figurativos de las marcas mediante una estructura jerárquica de tres niveles: 29 categorías, 145 divisiones y 1.780 secciones. De estas últimas, 845 son principales y 935 auxiliares.
Según explica a Ciencia del Sur el doctor José Luis Vázquez Noguera, uno de los investigadores del equipo y director del Laboratorio de Análisis y Modelado Basado en Datos (LAMBDA), los trabajos anteriores destinados a asistir automáticamente en la asignación de códigos de Viena se concentran principalmente en los dos primeros niveles de la jerarquía.
El problema se vuelve mucho más marcado al llegar al nivel más específico. “Existen 355 secciones sin datos de entrenamiento y otras 78 secciones con menos de 10 imágenes disponibles”, señala Vázquez Noguera.
Esto representa una dificultad importante para los sistemas tradicionales de clasificación de imágenes. Un modelo de aprendizaje automático suele funcionar mejor cuando dispone de numerosos ejemplos representativos de cada categoría. Cuando una categoría aparece pocas veces, el sistema tiene dificultades para aprender sus características. Si nunca aparece durante el entrenamiento, el problema es todavía mayor.
Imágenes y lenguaje en un mismo modelo
Para enfrentar esta dificultad, los investigadores de Paraguay y Corea del Sur utilizaron SigLIP2, un modelo de inteligencia artificial previamente entrenado con pares de imágenes y textos.
La idea central consiste en aprovechar que los códigos de la Clasificación de Viena no son solamente números. Cada código posee también una descripción textual de los elementos figurativos que representa. El sistema puede utilizar esa información para relacionar lo que observa en una imagen con el significado de las descripciones.
“Como los códigos de la Clasificación de Viena cuentan con descripciones textuales, podemos comparar un nuevo logotipo con esas descripciones e identificar qué códigos presentan mayor similitud semántica con los elementos visuales presentes en la imagen”, detalla el investigador.
En términos sencillos, el modelo aprende a representar imágenes y textos dentro de un mismo espacio semántico. Así, un logotipo puede compararse con las descripciones de los códigos de Viena y determinar cuáles presentan mayor correspondencia.
Esta característica permite abordar una limitación de los clasificadores tradicionales. “Gracias al conocimiento adquirido previamente sobre la relación entre imágenes y lenguaje, el modelo puede generalizar hacia categorías con muy pocos ejemplos e incluso sugerir categorías que no estuvieron presentes durante el entrenamiento supervisado”, señala Vázquez Noguera.
El entrenamiento con mejores resultados
Los investigadores evaluaron el modelo en dos modalidades. La primera fue zero-shot, es decir, sin realizar un entrenamiento específico con los datos etiquetados de las categorías que debía reconocer. La segunda consistió en un entrenamiento supervisado mediante LoRA utilizando datos de la Oficina de Propiedad Intelectual de la Unión Europea (EUIPO).
Este segundo enfoque obtuvo los mejores resultados entre los métodos comparados. Pero, además de mejorar su desempeño, conservó una característica particularmente relevante para el problema estudiado. Se trata de la posibilidad de sugerir códigos correspondientes a categorías que no habían estado representadas durante el entrenamiento supervisado.
Ese comportamiento es especialmente importante en una clasificación como la de Viena, donde existen numerosas categorías con una cantidad muy reducida de imágenes disponibles. El trabajo no fue concebido solamente como un experimento académico, ya que forma parte de un proyecto que busca desarrollar una herramienta tecnológica para apoyar el trabajo de los examinadores de marcas de la DINAPI.
Ante el ingreso de un logotipo, el sistema podrá sugerir códigos de la Clasificación de Viena y colaborar en la búsqueda de elementos figurativos similares. La inteligencia artificial, en este esquema, no sustituye al especialista.
“La idea no es reemplazar al especialista, sino empoderarlo mediante inteligencia artificial, proporcionándole herramientas que le permitan realizar su trabajo de manera más rápida, consistente y eficiente”, según Vázquez.
Una herramienta de este tipo podría reducir parte del trabajo manual involucrado en la búsqueda y clasificación de elementos figurativos y, al mismo tiempo, disminuir la variabilidad que puede producirse cuando diferentes operadores analizan una misma imagen.
El potencial no se limita a Paraguay. De acuerdo con el investigador, el proyecto puede constituir una referencia para otras oficinas de propiedad industrial de la región que enfrentan problemas similares y buscan incorporar inteligencia artificial en sus procesos.
Paraguay y la investigación en IA
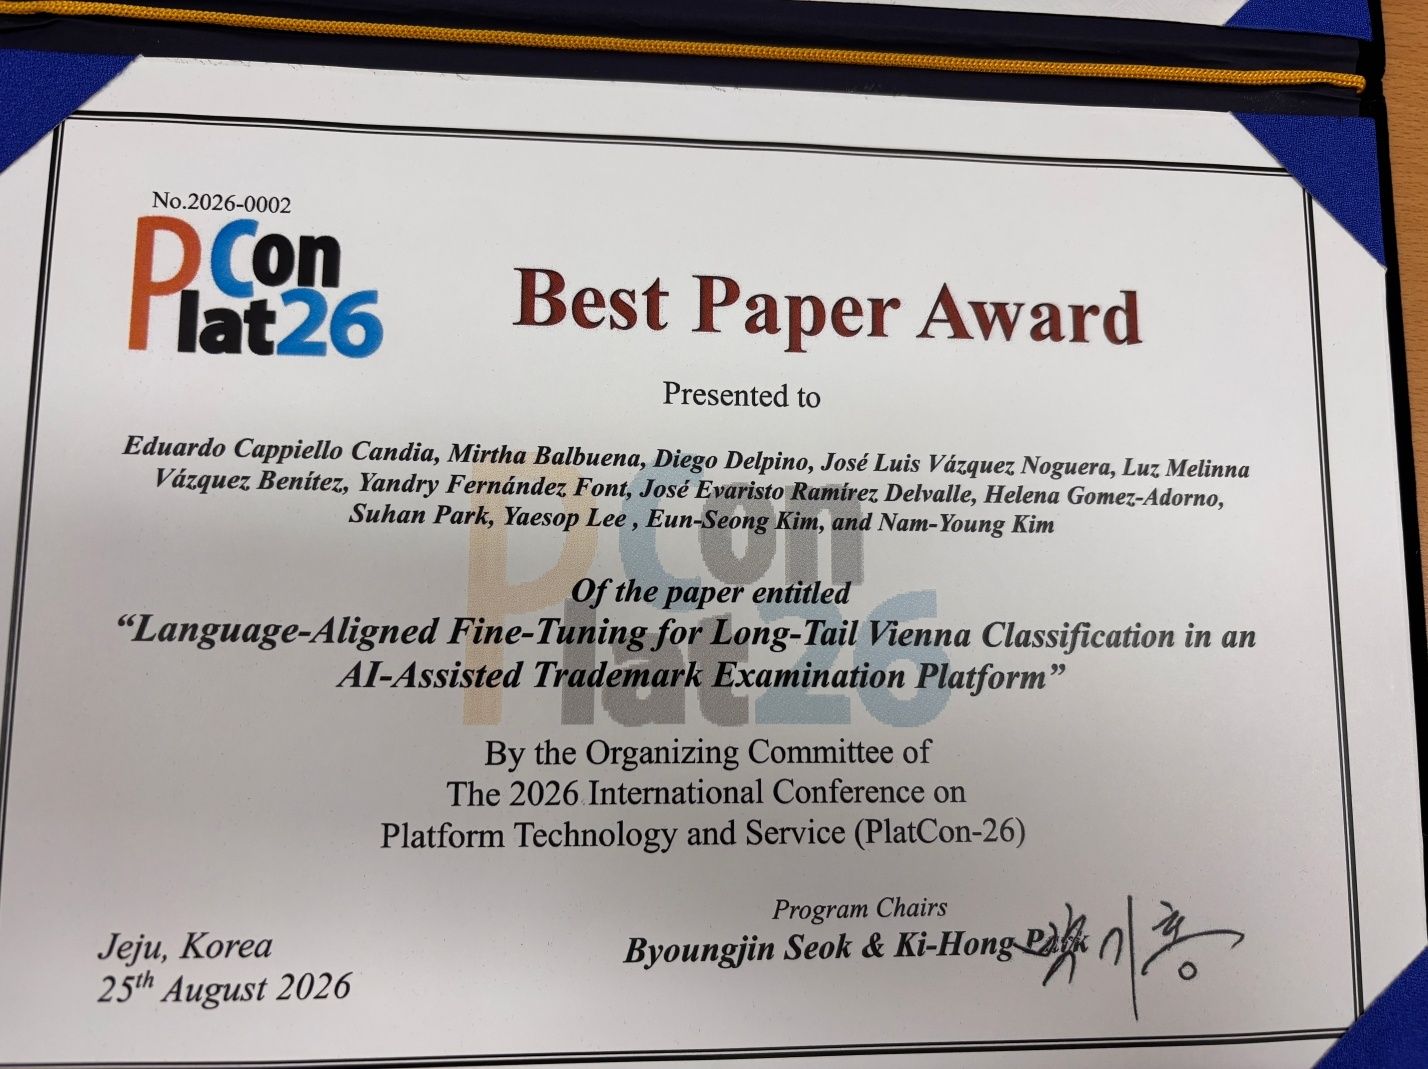
El reconocimiento obtenido en Corea del Sur también tiene una dimensión institucional y científica para todo el equipo, según comunicó Vázquez a Ciencia del Sur.
El trabajo fue presentado de manera virtual por Eduardo Cappiello, integrante del equipo paraguayo. Los investigadores paraguayos no viajaron presencialmente a Corea del Sur. En cambio, los coautores coreanos del trabajo participaron de manera presencial en PlatCon-26, en Jeju, y fueron quienes hicieron llegar al equipo paraguayo la fotografía del certificado correspondiente al premio.
El certificado reconoce a los doce autores por el artículo presentado en la conferencia y lleva la fecha del 25 de agosto de 2026, en Jeju, Corea. Para Vázquez Noguera, el reconocimiento constituye una señal de las capacidades que pueden desarrollarse desde Paraguay en áreas avanzadas de inteligencia artificial.
“Demuestra que desde nuestro país podemos no solamente adoptar herramientas de inteligencia artificial desarrolladas en otros lugares, sino también investigar, desarrollar y generar soluciones propias para problemas reales, y que esos resultados pueden alcanzar reconocimiento internacional”, afirma.
La colaboración con investigadores coreanos también permite ampliar las capacidades locales mediante el intercambio de conocimiento y la generación de vínculos científicos y tecnológicos.
En este caso, el resultado combina tres elementos. Una problemática concreta de la propiedad intelectual, una técnica contemporánea de inteligencia artificial y una colaboración internacional orientada a desarrollar una herramienta para una institución pública paraguaya.
El premio obtenido en PlatCon-26 reconoce precisamente esa investigación, desarrollada entre Paraguay y Corea del Sur, sobre uno de los problemas más difíciles de la clasificación automática de imágenes: cómo enseñar a una inteligencia artificial a reconocer categorías de las que casi no existen ejemplos.
¿Qué te pareció este artículo?